Checklista migracji do chmury — plan, testy i rollback
Checklista migracji do chmury jest operacyjną listą dowodów dla jednego systemu: inwentaryzacji, właścicieli, zależności, docelowej architektury, odpowiedzialności klienta i dostawcy, zabezpieczeń, transferu danych, testów, przełączenia oraz rollbacku. Migrację można dopuścić dopiero wtedy, gdy kryteria są mierzalne, kopia została odtworzona, monitoring działa, a osoba decyzyjna zna warunki powrotu. Sama umowa z dostawcą ani udane skopiowanie danych nie oznaczają gotowości produkcyjnej.
1. Ustal zakres i przygotuj kartę migracji
Wypełniaj osobną checklistę dla konkretnego obciążenia, a nie dla „całej chmury”. Obciążeniem może być aplikacja wraz z bazą i zależnościami, usługa plikowa albo system analityczny. Zbyt szeroki zakres ukrywa różne poziomy krytyczności; zbyt wąski pomija komponenty niezbędne do działania.
| Pole | Co zapisać | Kto zatwierdza |
|---|---|---|
| Obciążenie i środowiska | Nazwa systemu, produkcja, test, development oraz elementy objęte i wyłączone z migracji. | Właściciel systemu |
| Role | Właściciel biznesowy, techniczny, danych, bezpieczeństwa, migracji i osoba podejmująca decyzję o rollbacku. | Sponsor / właściciel |
| Krytyczność | Wpływ niedostępności, utraty danych, naruszenia poufności i błędnego działania. | Właściciel ryzyka |
| Cele techniczne | RTO, RPO, wymagania wydajnościowe, okno zmiany oraz minimalna funkcjonalność po przełączeniu. | Właściciel i operacje |
| Kryteria sukcesu | Mierzalne testy, które muszą przejść: funkcje, dane, wydajność, logi, kopia i odtworzenie. | Właściciel systemu |
| Kryteria przerwania | Warunki no-go i rollbacku, termin ostatniej bezpiecznej decyzji oraz osoba z prawem jej podjęcia. | Właściciel zmiany |
| Okres stabilizacji | Czas wzmożonego monitoringu, dyżury, kanał eskalacji i warunki zamknięcia migracji. | Operacje |
2. Zrób inwentaryzację systemu, danych i zależności
Najczęstsza luka migracyjna nie dotyczy docelowej maszyny, lecz niewidocznej zależności: wpisu DNS, certyfikatu, serwera czasu, konta usługi, reguły IP, zadania nocnego albo wymiany plików z partnerem. Inwentaryzację trzeba potwierdzić obserwacją ruchu i rozmową z właścicielami, a nie tylko starym diagramem.
- Komponenty: spisz aplikacje, bazy, kolejki, magazyny, maszyny, kontenery, zadania okresowe, wersje i elementy po zakończeniu wsparcia.
- Przepływy: zmapuj połączenia przychodzące i wychodzące, porty, protokoły, wolumen, opóźnienie oraz wymagany kierunek inicjowania sesji.
- Tożsamości: zinwentaryzuj użytkowników, grupy, konta techniczne, klucze, certyfikaty, tokeny, integracje SSO i proces usuwania dostępu.
- Dane: wskaż właściciela każdego zbioru, klasyfikację, rozmiar, tempo wzrostu, retencję, format, miejsce kopii i wymagania lokalizacyjne.
- Zależności zewnętrzne: potwierdź DNS, pocztę, płatności, katalog tożsamości, monitoring, kopie, repozytoria, licencje, urządzenia i partnerów.
- Profil pracy: zmierz ruch, wykorzystanie zasobów, czasy odpowiedzi, błędy, szczyty sezonowe i typowy koszt obecnego środowiska.
- Stan odtworzenia: zapisz datę ostatniego pełnego testu kopii oraz rzeczywisty czas i punkt odzyskania.
- Właścicielstwo: do każdego elementu przypisz osobę odpowiedzialną i decyzję: przenieść, pozostawić, zastąpić albo wyłączyć.
3. Opisz środowisko docelowe i metodę migracji
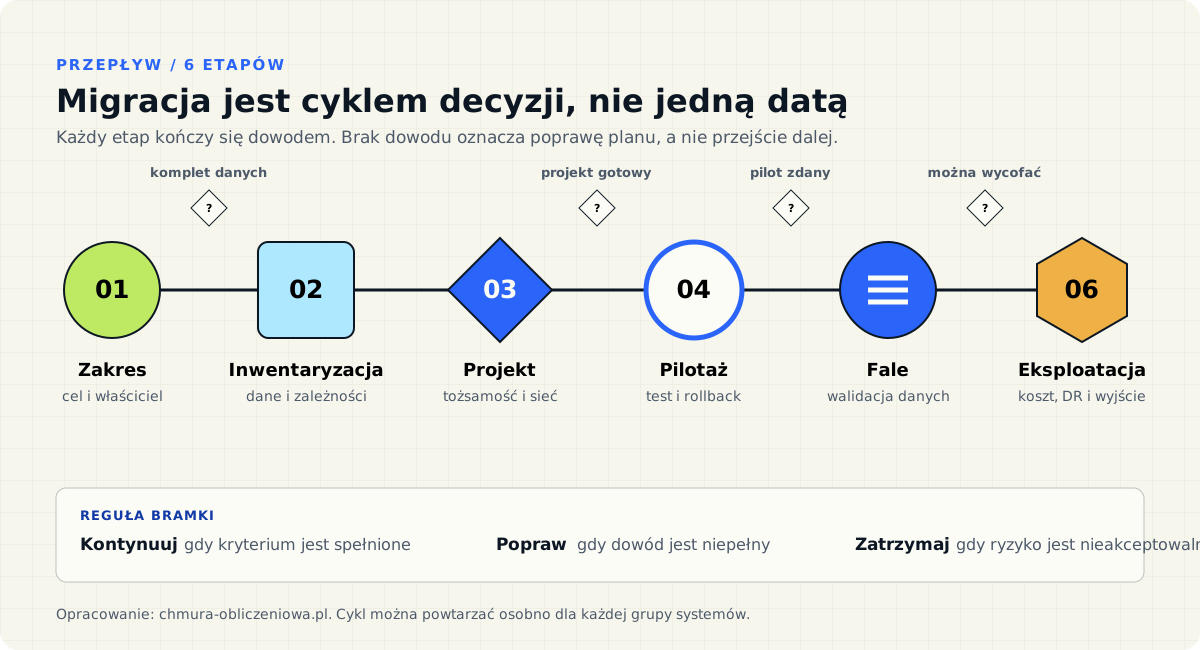
Najpierw narysuj stan docelowy, potem wybierz ruch danych i kolejność. CISA podkreśla, że jedna organizacja może potrzebować różnych strategii dla różnych aplikacji. Przeniesienie bez zmian (rehost) skraca część prac, ale zachowuje ograniczenia źródła; replatforming lub refaktoryzacja zmieniają więcej elementów i wymagają szerszych testów.
- Wybierz dla każdego komponentu metodę: wycofanie, pozostawienie, zastąpienie usługą, rehost, replatforming albo refaktoryzacja — i zapisz uzasadnienie techniczne.
- Narysuj docelowe konta lub projekty, regiony, strefy, sieci, punkty wejścia, przepływy danych, tożsamości, logi, kopie i połączenie ze środowiskiem źródłowym.
- Potwierdź dostępność wybranej usługi, funkcji, limitów, typu wsparcia i SLA w docelowym regionie.
- Zgrupuj razem elementy, które nie tolerują opóźnienia albo nie mogą bezpiecznie działać w rozdzielonym środowisku.
- Zaplanuj mechanizm synchronizacji i rozstrzygania zmian w okresie, gdy źródło i cel działają równolegle.
- Oszacuj czas transferu na podstawie rzeczywistego wolumenu, przepustowości, narzutu szyfrowania i okna zmiany; wykonaj próbę na reprezentatywnej próbce.
- Sprawdź format eksportu danych i konfiguracji, zależności od usług własnościowych oraz koszt transferu wychodzącego.
- Zdefiniuj stan źródła po przełączeniu: tylko do odczytu, gotowy do rollbacku, archiwizowany albo wyłączany po zatwierdzonym okresie.
4. Porównaj odpowiedzialność klienta i dostawcy
Dostawca zabezpiecza chmurę w zakresie opisanym dla produktu, a klient zabezpiecza własne użycie usługi. W IaaS po stronie klienta pozostaje więcej warstw niż w PaaS i SaaS, lecz dane, konta, uprawnienia i decyzje konfiguracyjne nie znikają w żadnym modelu. Poniższa macierz zamienia ogólną zasadę na dowody potrzebne przed produkcyjnym uruchomieniem.
| Obszar | Dostawca | Klient | Dowód przed go-live |
|---|---|---|---|
| Centrum danych, sprzęt, fizyczna sieć i hiperwizor | Chroni i utrzymuje infrastrukturę objętą usługą. | Wybiera usługę, region i wymagany poziom zapewnienia. | Zakres usługi, dokument odpowiedzialności i raporty dotyczące właściwego produktu. |
| System, runtime i middleware | Utrzymuje warstwy włączone do PaaS/SaaS; w IaaS utrzymuje bazową platformę wirtualizacji. | W IaaS utrzymuje system gościa i własny stos; w PaaS konfiguruje dostępne elementy runtime. | Lista warstw, właściciel poprawek, terminy i sposób weryfikacji wersji. |
| Aplikacja i integracje | Utrzymuje aplikację SaaS i udostępnia mechanizmy platformy zgodnie z dokumentacją. | Odpowiada za własny kod w IaaS/PaaS oraz konfigurację, integracje i sposób użycia SaaS. | Testy kodu i integracji, właściciel konfiguracji, plan podatności i zmian. |
| Dane | Zapewnia techniczne mechanizmy przechowywania i ochrony objęte usługą. | Klasyfikuje dane, ustala cel, dostęp, retencję, lokalizację i dopuszczalne użycie. | Rejestr zbiorów, ustawienia usługi, warunki umowne i zaakceptowany przepływ danych. |
| Tożsamości i uprawnienia | Utrzymuje usługę IAM oraz jej udokumentowane funkcje. | Tworzy i usuwa konta, nadaje role, wymusza uwierzytelnienie i przegląda dostęp. | Eksport ról, test MFA, konto awaryjne, negatywny test dostępu i właściciele grup. |
| Szyfrowanie, klucze i sekrety | Udostępnia i obsługuje mechanizmy deklarowane dla usługi. | Wybiera model kluczy, ogranicza ich użycie, rotuje sekrety i nie umieszcza ich w kodzie. | Konfiguracja szyfrowania, uprawnienia do kluczy, test rotacji i procedura utraty klucza. |
| Kopie i odtworzenie | Realizuje funkcje kopii lub odporności dokładnie w zakupionym i skonfigurowanym zakresie. | Ustala RPO/RTO, włącza właściwy zakres, chroni kopie i sprawdza pełne odtworzenie. | Wynik testu restore, retencja, lokalizacja, właściciel i zmierzony czas odzyskania. |
| Logi i wykrywanie | Generuje i udostępnia sygnały opisane dla platformy lub aplikacji. | Włącza potrzebne logi, ustala retencję, zabezpiecza je, buduje alarmy i reaguje. | Przykładowe zdarzenie widoczne w centralnym systemie oraz sprawdzony alarm. |
| Dostępność | Utrzymuje bazową platformę i realizuje SLA na swoich warunkach. | Projektuje aplikację, rozmieszcza zasoby i używa funkcji odporności zgodnie z RTO/RPO. | Test awarii komponentu lub strefy, analiza pojedynczych punktów awarii i runbook. |
| Incydent | Obsługuje incydenty swojej infrastruktury i powiadamia w zakresie zobowiązań. | Obsługuje incydenty obciążenia, zabezpiecza ślady i koordynuje kontakt z dostawcą. | Kontakty, poziom wsparcia, kanał poza podstawowym IAM i przećwiczony scenariusz. |
| Wyjście i usunięcie | Udostępnia eksport i usuwa dane w zakresie funkcji oraz warunków usługi. | Planuje wyjście, wykonuje eksport, sprawdza kompletność i zatwierdza usunięcie źródła. | Próbny eksport, koszt, czas, format, zależności i sposób potwierdzenia usunięcia. |
Macierz jest punktem startowym, nie interpretacją umowy. Granicę należy potwierdzić osobno dla każdej używanej usługi, konfiguracji i podwykonawcy. Pełną macierz on-prem/IaaS/PaaS/SaaS zawiera model współdzielonej odpowiedzialności, a zakres usług wyjaśnia przewodnik po IaaS, PaaS i SaaS.
5. Przygotuj landing zone, tożsamość i zabezpieczenia
Produkcyjnego systemu nie należy przenosić do przypadkowego konta utworzonego na potrzeby testu. Landing zone stanowi przygotowany fundament organizacyjny i techniczny: hierarchię zasobów, konta, sieci, IAM, polityki, logowanie i rozliczenia. Zakres powinien odpowiadać pierwszemu obciążeniu, ale umożliwiać kontrolowane dodawanie następnych.
- Struktura: rozdziel środowiska produkcyjne i nieprodukcyjne, określ właścicieli kont, subskrypcji lub projektów oraz ścieżkę zatwierdzania nowych zasobów.
- Tożsamość: zintegruj katalog, używaj grup zamiast nadań osobowych, oddziel tożsamości ludzi i usług, wymuś MFA dla uprzywilejowanego dostępu.
- Konto awaryjne: przygotuj chroniony dostęp break-glass niezależny od typowej awarii logowania i sprawdź go w kontrolowanym teście.
- Najmniejsze uprawnienia: usuń role tymczasowe po migracji, ogranicz stałych administratorów i zaplanuj cykliczny przegląd dostępów.
- Sieć: zatwierdź trasy, DNS, zapory, dostęp administracyjny, egress i połączenia hybrydowe; przetestuj również zablokowane kierunki.
- Guardrails: ustaw polityki zapobiegające niedozwolonym regionom, publicznym zasobom albo wyłączeniu wymaganych logów — adekwatnie do projektu.
- Logi: włącz zdarzenia administracyjne, IAM, sieci i danych przed rozpoczęciem migracji; centralizuj je i ogranicz możliwość modyfikacji.
- Klucze i sekrety: przechowuj je w przeznaczonych usługach, ustal właścicieli, rotację, odzyskanie i sposób użycia przez automatyzację.
- IaC: wersjonuj definicje infrastruktury, wykonuj przegląd zmian, testuj je w środowisku nieprodukcyjnym i nie zapisuj sekretów w repozytorium.
- Koszt operacyjny: oznacz zasoby właścicielem, środowiskiem i centrum kosztu; ustaw budżety, alarmy oraz limity chroniące przed niekontrolowanym użyciem.
- Wsparcie: potwierdź aktywny poziom wsparcia, osoby uprawnione do zgłoszeń i kanał eskalacji działający również podczas awarii IAM.
6. Zabezpiecz transfer danych, kopie i odtwarzanie
Transfer jest zakończony dopiero wtedy, gdy można wykazać kompletność, spójność i możliwość użycia danych w systemie docelowym. CISA wskazuje kontrolę integralności podczas migracji; NIST zaleca planowanie ciągłości wraz z analizą wpływu, strategią odtworzenia, testami i utrzymaniem planu.
- Usuń z zakresu zbędne dane zgodnie z zatwierdzoną retencją; nie kopiuj automatycznie wszystkiego „na wszelki wypadek”.
- Ustal, kiedy źródło przejdzie w tryb tylko do odczytu albo jak będą synchronizowane zmiany powstające podczas transferu.
- Wykonaj pełną kopię przed zmianą i potwierdź możliwość odtworzenia bez użycia kont, kluczy lub narzędzi, które migracja może unieruchomić.
- Szyfruj kanał transferu, ogranicz dostęp do tymczasowych plików i ustal termin ich usunięcia.
- Porównaj sumy kontrolne, liczbę rekordów lub obiektów, kluczowe agregaty i relacje; sam zgodny rozmiar pliku jest niewystarczający.
- Sprawdź kodowanie, strefy czasowe, uprawnienia do obiektów, kolejność zdarzeń i zachowanie aplikacji na reprezentatywnej próbce.
- Włącz docelowy harmonogram kopii, retencję, ochronę przed usunięciem i alarm o nieudanym zadaniu przed go-live.
- Wykonaj pełny test odtworzenia w środowisku docelowym i zmierz rzeczywiste RTO oraz RPO.
- Zapisz, które dane pozostają w źródle, jak długo i kto po okresie stabilizacji może zatwierdzić ich archiwizację lub usunięcie.
7. Przeprowadź testy i podejmij decyzję go/no-go
Pilot powinien obejmować ten sam typ danych, połączeń i kontroli co produkcja, choć może działać w mniejszej skali. Test pozytywny pokazuje, że funkcja działa; test negatywny sprawdza, czy niedozwolony dostęp i błędna konfiguracja są blokowane albo wykrywane.
Użytkownik i integracje
Przejdź krytyczne ścieżki użytkownika, zadania okresowe, API i wymianę danych. Zapisz wynik, wersję i właściciela akceptacji.
Kompletność i spójność
Porównaj rekordy, obiekty, sumy kontrolne i raporty biznesowe. Wyjaśnij każdą różnicę przed przełączeniem.
Pomiar wobec progu
Zmierz czasy odpowiedzi, przepustowość i zachowanie przy szczycie. Nie opieraj akceptacji na wrażeniu z pojedynczej sesji.
Dostęp dozwolony i zabroniony
Sprawdź MFA, role, konta usług, sekrety, publiczną ekspozycję i próbę działania użytkownika bez wymaganych uprawnień.
Log, alarm i eskalacja
Wygeneruj kontrolowane zdarzenie, znajdź je w centralnych logach, odbierz alarm i uruchom ścieżkę reakcji.
Awaria, restore i rollback
Przetestuj utratę wybranego komponentu, odtworzenie z kopii oraz powrót do źródła w dopuszczalnym czasie.
| Warunek | GO | NO-GO lub decyzja o odstępstwie |
|---|---|---|
| Zakres i właściciele | Komponenty, role i zależności są zatwierdzone. | Brakuje właściciela systemu, danych albo decyzji o rollbacku. |
| Dane | Próba migracji jest kompletna i spójna według mierzalnych testów. | Różnice są niewyjaśnione albo nie ma metody porównania. |
| Odtworzenie | Pełny restore przeszedł, a zmierzone wartości mieszczą się w RTO/RPO. | Istnieje kopia, lecz nie została odtworzona lub wymaga niedostępnych zależności. |
| Dostęp i logi | Role, MFA, dostęp awaryjny, centralne logi i alarm są sprawdzone. | Administratorzy mają niekontrolowany dostęp albo zdarzeń nie można wykryć. |
| Funkcje i wydajność | Krytyczne ścieżki spełniają ustalone progi. | Test pomija ważną integrację lub próg nie został osiągnięty. |
| Rollback | Procedura, czas graniczny i decydent są znani; test zakończył się powodzeniem. | Powrót zależy od improwizacji albo stan źródła nie będzie spójny. |
8. Wykonaj przełączenie z gotowym rollbackiem
Plan przełączenia powinien być sekwencją działań z właścicielami, oczekiwanym wynikiem i punktem kontroli. Nie zakładaj, że decyzję o powrocie można odłożyć do końca okna: po określonym czasie albo po zmianie schematu danych rollback może wymagać osobnej migracji wstecz.
Runbook powinien działać także bez głównego komunikatora, panelu administracyjnego lub katalogu tożsamości. Zapisz numery telefonów, alternatywny kanał, dane potrzebne do zgłoszenia u dostawcy i lokalizację instrukcji dostępną w sytuacji awarii.
9. Skontroluj środowisko po migracji
Migracja nie kończy się po zmianie DNS lub uruchomieniu aplikacji. Okres stabilizacji ma potwierdzić, że procesy operacyjne działają w nowym modelu odpowiedzialności i że środowisko źródłowe można bezpiecznie ograniczyć.
- Porównaj rzeczywiste zasoby, połączenia i dane z zatwierdzonym diagramem; usuń niekontrolowane elementy pilota.
- Cofnij tymczasowe role, klucze, wyjątki zapory, podwyższone limity i konta migracyjne.
- Sprawdź pierwsze wykonania kopii, zadań okresowych, rotacji sekretów, raportów, alarmów i integracji z partnerami.
- Porównaj wydajność, błędy, dostępność, użycie i koszt z progami z karty migracji.
- Zaktualizuj runbooki, inwentaryzację, diagramy, właścicieli, procedurę incydentu i instrukcję odtworzenia.
- Wykonaj przegląd odpowiedzialności dla każdej usługi, zwłaszcza jeśli pilot został zastąpiony innym wariantem produktu.
- Zamknij lub zarchiwizuj źródło dopiero po akceptacji właściciela danych, upływie okresu rollbacku i potwierdzeniu wymaganych kopii.
- Zaplanuj cykliczne testy odtworzenia, przeglądy dostępu, aktualizację obrazu/systemu, kontrolę kosztów i próbę eksportu.
- Przeprowadź retrospektywę i wprowadź poprawki do szablonu przed kolejną falą migracyjną.
Najczęstsze pytania o migrację do chmury
Od czego zacząć migrację do chmury?
Od wyznaczenia właścicieli i inwentaryzacji jednego obciążenia: komponentów, danych, tożsamości, połączeń i kryteriów odtworzenia. Wybór narzędzia do kopiowania danych jest późniejszym krokiem.
Kto odpowiada za bezpieczeństwo po migracji?
Dostawca i klient, w różnych zakresach. Dostawca utrzymuje infrastrukturę i warstwy objęte produktem. Klient nadal odpowiada za dane, konta, uprawnienia, konfigurację, własny kod i wykorzystanie dostępnych mechanizmów ochrony.
Czy dostawca odpowiada za backup?
Tylko w zakresie konkretnej usługi, konfiguracji i umowy. Klient powinien ustalić wymagane RPO/RTO, włączyć odpowiedni zakres kopii, zabezpieczyć dostęp i potwierdzić pełne odtworzenie.
Czym różni się rehost od replatformingu?
Rehost odtwarza podobny stos na zasobach chmurowych z małą liczbą zmian. Replatforming zastępuje część warstw usługami zarządzanymi lub zmienia platformę uruchomieniową bez pełnego przeprojektowania aplikacji.
Co musi zawierać plan rollbacku?
Warunki uruchomienia, osobę decyzyjną, graniczny czas decyzji, stan danych po obu stronach, procedurę ruchu wstecz, wymagane konta i klucze oraz test potwierdzający wykonalność w oknie.
Kiedy można wyłączyć stary system?
Po zakończeniu uzgodnionego okresu stabilizacji, spełnieniu kryteriów akceptacji, potwierdzeniu kopii i odtworzenia oraz decyzji właściciela danych. Wyłączenie i usunięcie danych powinny być odrębnymi, kontrolowanymi krokami.
Czy checklista zastępuje audyt bezpieczeństwa?
Nie. Pomaga zebrać dowody i zapobiec typowym pominięciom, ale zakres testów bezpieczeństwa powinien wynikać z ryzyka, architektury, danych, sektora i wymagań organizacji.
Czy tę checklistę można stosować do SaaS?
Tak, po dopasowaniu zakresu. Dla SaaS mniej uwagi wymaga system operacyjny, a więcej konfiguracja tenantu, tożsamości, integracje, retencja, eksport, logi, urządzenia użytkowników i proces zamknięcia usługi.
Źródła
- CISA — Cloud Security Technical Reference Architecture v2: migracja, usługi wspólne i bezpieczeństwo chmury
- NIST Cybersecurity Framework 2.0 — zarządzanie, identyfikacja, ochrona, wykrywanie, reakcja i odtwarzanie
- NIST SP 800-210 — kontrola dostępu w IaaS, PaaS i SaaS
- NIST SP 800-34 Rev. 1 — analiza wpływu, strategie odtworzenia i testowanie planów ciągłości
- NIST SP 800-146 — szanse, ryzyka i rekomendacje dotyczące adopcji chmury
- Microsoft Azure — szczegółowa macierz współdzielonej odpowiedzialności
- AWS — bezpieczeństwo chmury a bezpieczeństwo w chmurze
- Google Cloud — definiowanie środowiska źródłowego, docelowego i gotowości migracyjnej
- Google Cloud — elementy i projekt landing zone
- Microsoft Cloud Adoption Framework — zależności, fale, rollback i decyzja go/no-go
- Microsoft — wersjonowana i powtarzalna infrastruktura jako kod
Checklista jest materiałem technicznym i organizacyjnym. Nie zastępuje warunków umowy, analizy ryzyka, testów właściwych dla systemu ani oceny wymagań prawnych i sektorowych.